1 min de lecture
La check-list pour tester son tunnel de commande
Huit vérifications à faire avant chaque mise en ligne importante, du panier à l’e-mail de confirmation, avec les cas d’erreur : code expiré, carte refusée.
Créer vos tests
Les exécuter
Les adapter
Par moment
Par profil
Évaluer
Un dossier, une commande : Claude explore un site, planifie ses tests, les exécute avec Playwright et rend un rapport prouvé. 15 minutes de mise en place.
 Antoine BouchetPrésident, produit
Publié le 7 min de lecture
Comment j’ai donné une spec à Claude pour qu’il écrive et exécute son propre plan de test E2E, dans un vrai navigateur, avec un rapport visuel à la clé.
On décrit un site à tester dans un simple fichier texte. Claude l’explore tout seul, planifie une liste de tests, les exécute dans un vrai navigateur via Playwright, puis produit un rapport visuel avec un verdict honnête pour chacun : 🟢 OK, 🔴 bug, ou 🟠 « à vérifier ».
Le mot-clé, c’est autonome mais auditable : Claude fait le travail, mais chaque verdict est appuyé sur une observation et une capture d’écran. Pas de magie noire.
À la fin de ce tutoriel, tu auras un dossier qui enchaîne plan → test → rapport en une commande. Compte 15 minutes de mise en place.
Tu n’as pas besoin de savoir coder, ni de maîtriser Node.js ou Playwright. Node.js tourne en coulisses, et c’est Claude Code qui pilote le navigateur pour toi. Concrètement : tu télécharges le dossier, tu ouvres Claude Code dedans, et tu lui parles.
Tu n’as rien à construire : le dossier qa-agent est déjà organisé autour de commandes Claude Code (des fichiers Markdown) et de deux scripts. Voici ce qu’il contient :
qa-agent/
├── .claude                  # /preparer, /cible, /plan, /test, /rapport, /agent-qa
├── cible.md                 # CE QU'ON VEUT TESTER (le seul fichier qu'on remplit)
├── lancer.mjs               # enchaîne plan → test → rapport
├── construire-rapport.mjs   # génère le rapport HTML
└── captures/                # captures d'écran (preuves)
Le principe directeur : tout est en Markdown lisible par un humain. Pas de JSON dans les fichiers de travail. N’importe qui peut relire le plan et les résultats sans savoir coder.
Le branchement du navigateur est géré par Claude Code. Il détecte tout seul son besoin et te demande simplement, la première fois, d’autoriser le « serveur Playwright ». Tu acceptes, et c’est fait. Pareil pour Node.js.
Tu ne remplis aucun fichier à la main. Tu lances l’agent, par exemple en écrivant « Je veux lancer l’agent QA » (ou la commande /agent-qa), et c’est Claude Code qui s’occupe de tout.
Il fera d’abord toutes les vérifications techniques nécessaires pour s’assurer qu’il dispose bien de tout ce dont il a besoin, puis il te posera des questions :
À partir de tes réponses, Claude remplit lui-même le fichier cible.md : tu n’as pas à y toucher. Le résultat ressemble à ceci :
## URL du site
https://www.monsite.com/

## Ce que je veux tester
Aucune spec : test « à l'aveugle ». Découvre le site et couvre les fondamentaux.

## Nombre de tests souhaité (indicatif)
~10

## Limites à respecter
- Ne PAS soumettre de formulaire pour de vrai (pas de compte, pas de paiement).
- Rester en lecture/navigation : aucune action destructrice.
Deux choses comptent : la spec (ou « aucune ») et les limites. Les limites sont sacrées : c’est ce qui empêche l’agent d’envoyer un vrai formulaire de contact ou de déclencher un paiement. Si tu n’en précises pas, l’agent reste par défaut en lecture/navigation, sans rien casser.
⚠ Ce projet est modulable. Si quelque chose n’est pas fait comme tu le souhaites, si tu as des besoins spécifiques, demande-lui ce qui doit être modifié dans le projet : il saura faire les ajustements nécessaires.
Première phase. Claude lit cible.md, explore le site dans le navigateur, et écrit un plan dans plan-de-test.md. Il ne lance aucun test ici : il observe et planifie.
Cette phase devrait se lancer automatiquement ; si ce n’est pas le cas, demande-le à Claude.
Résultat : un plan numéroté, lisible, du genre T01 — La page d'accueil se charge, avec objectif, étapes et résultat attendu.
💡 Pourquoi séparer plan et exécution ? Parce que le plan est un artefact qu’un humain relit et corrige avant de lancer les tests. C’est ce qui rend le système auditable plutôt qu’une boîte noire.
Deuxième phase. Claude joue chaque test du plan dans le navigateur, prend une capture-preuve par test, et écrit un verdict honnête dans resultats.md.
Les trois règles d’or de cette phase :
Ce 🟠, c’est le cœur de l’honnêteté du système. Un testeur qui invente des « OK » est pire qu’inutile. Ici, l’incertitude est un statut de première classe.
Troisième phase : Claude Code transforme resultats.md et les captures en un rapport autonome (un seul fichier, captures intégrées, ouvrable hors ligne).
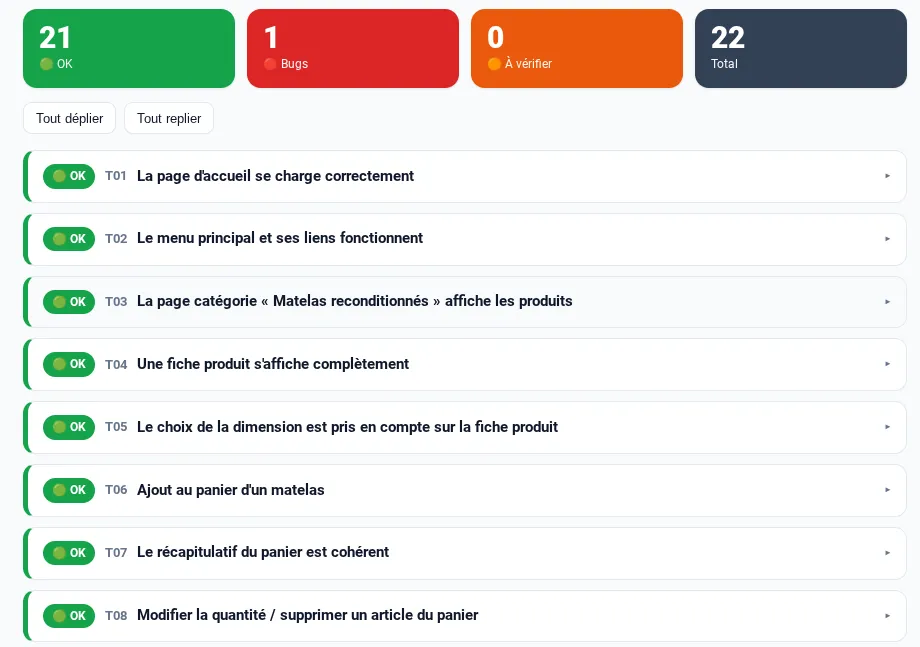
⚠ La leçon la plus importante du projet. J’ai d’abord demandé à Claude de générer lui-même le HTML du rapport. Mauvaise idée : encoder plus de 20 captures en base64 dans un seul appel, c’est trop lourd. La phase « échouait » en silence et laissait un vieux rapport en place. La bonne approche : générer le rapport de façon déterministe avec un script Node. Fiable à 100 %, et ça libère l’IA des tâches mécaniques pour lesquelles elle n’apporte rien.
Le script construire-rapport.mjs lit le Markdown des résultats, encode les captures, et produit une scorecard (compteurs 🟢/🔴/🟠) plus une carte-accordéon par test : en-tête cliquable, chevron qui pivote, bugs ouverts par défaut. Le lecteur déplie ce qui l’intéresse.
Règle générale à retenir : fais faire à l’IA ce qui demande du jugement (explorer, juger un verdict), et au code ce qui demande de la fiabilité (assembler un fichier).
Pour ne plus rien taper à la main, tu peux demander à Claude Code de lancer tous les processus (node lancer.mjs).
Le script enchaîne les phases IA (plan → test) en mode non interactif, puis génère le rapport en local, additionne les tokens consommés, et archive le rapport de chaque passage dans son propre dossier :
runs/
├── monsite_2026-06-01_15-11/rapport.html
└── maboutique_2026-05-28_09-30/rapport.html
Le « sujet » (monsite, maboutique) est déduit automatiquement de l’URL, et la date-heure évite d’écraser un passage précédent. Tu gardes ainsi un historique par site, dans le temps.
Comme c’est une seule commande, tu peux demander à Claude Code de te faire un cron, pour une surveillance quotidienne par exemple.
runs/<sujet>_<date>/ par passage (étape 6)..gitignore.En une commande, j’ai un testeur qui :
Le tout reste local et auditable : le plan se relit, les verdicts s’appuient sur des captures, et chaque passage est archivé. Autonome, mais sous contrôle.
Le code complet (commandes et scripts) tient dans un dossier que tu peux télécharger et lancer en 15 minutes. C’est exactement l’esprit de Qanary : des tests sérieux, sans la friction.
Soyons clairs sur le bon usage, parce que c’est là que tout se joue.
Cet agent brille pour une chose : l’exploration. Découvrir un site, balayer large, vérifier les fondamentaux, lever des doutes : c’est là qu’il est imbattable, parce qu’il comprend ce qu’il voit et s’adapte tout seul.
En revanche, pour de l’automatisation précise et répétée (rejouer chaque jour exactement le même scénario de non-régression), une plateforme dédiée comme Qanary est plus pertinente. Tu ne veux pas qu’un test « réfléchisse » à nouveau chaque matin : tu veux qu’il reproduise le scénario à l’identique, vite et de façon déterministe. Un agent qui réinterprète la page à chaque passage, c’est génial pour découvrir… et contre-productif quand tu cherches la stabilité.
Faire réfléchir une IA à chaque étape, ça consomme des tokens, beaucoup de tokens. Pour une exploration ponctuelle, le rapport valeur/effort est excellent : quelques euros pour un audit complet, c’est imbattable. Mais si tu veux faire tourner 50 tests par jour, tous les jours, la facture devient vite déraisonnable. Tu paierais de l’intelligence là où tu n’as besoin que de répétition fiable.
C’est aussi l’une des raisons d’utiliser Qanary. Notre parti pris : mettre l’IA aux bons endroits (comprendre une page, valider des étapes, expliquer un échec en langage clair), mais garder une base algorithmique classique de tests automatisés pour l’exécution répétée. Résultat : 70 fois moins cher et plus pertinent sur les tests répétitifs de non-régression, là où l’IA pure coûterait trop et déraperait.
La bonne question n’est pas « IA ou pas IA ? », mais « de l’IA, où exactement ? ». Explorer avec un agent autonome ; automatiser au quotidien avec une plateforme comme Qanary.
1 min de lecture
Huit vérifications à faire avant chaque mise en ligne importante, du panier à l’e-mail de confirmation, avec les cas d’erreur : code expiré, carte refusée.
2 min de lecture
Pas besoin de tout tester : partez des parcours qui font votre chiffre d’affaires, classez-les par risque et commencez par le paiement.
2 min de lecture
Le compte à rebours des tests, de dix jours avant au lendemain, pour que votre tunnel tienne le jour où ça compte. Black Friday 2026 : le 27 novembre.
Promis, je ne cherche que les bugs.
Cinq canaris sont cachés dans le site. Ils dépassent des bords. Tous trouvés : un cadeau vous attend.
Mode réunion activé : les canaris restent cachés. Désactivez-le plus bas pour jouer.
30 minutes, en direct sur votre site
On regarde votre site ensemble ?

